Second Brain e agenti AI: fare di più non significa imparare di più
Ho costruito un Second Brain personale su un mini PC, con Telegram, Markdown, Git e Claude Code. Ma l’obiettivo non è delegare la conoscenza all’AI: è imparare davvero da ciò che faccio.
Con gli agenti AI sto facendo sempre più cose. Ma quanto sto imparando realmente?
Parlo per me, ma immagino sia una sensazione condivisa da molti sviluppatori. Con strumenti come Claude e ChatGPT riesco a sperimentare nuove tecnologie, sviluppare progetti e risolvere problemi molto più velocemente di prima. A volte, però, arrivo al risultato senza aver davvero assimilato quello che ho fatto.
Quali decisioni sono state prese? Perché quella soluzione funziona? Saprei spiegarla a un’altra persona, oppure riprodurla senza l’aiuto dell’agente?
È da queste domande che è nato il mio Second Brain personale.
Un archivio per imparare, non solo per ricordare
Mi sono ispirato alle riflessioni di Andrej Karpathy sulle LLM Wiki e al metodo Building a Second Brain di Tiago Forte. Mi interessa l’idea di conservare informazioni fuori dalla testa, renderle ricercabili e recuperarle quando servono. Ma nel mio progetto voglio mettere al centro un obiettivo preciso: non soltanto conservare la conoscenza, ma imparare attraverso il processo di organizzarla.
Se un agente legge, riassume, collega e archivia tutto al posto mio, il mio archivio diventa più ricco. Non è detto, però, che lo diventi anche la mia comprensione.
Il rischio è confondere due cose diverse: avere accesso a un’informazione e averla capita. Un archivio può crescere ogni giorno, riempirsi di spiegazioni corrette e collegamenti utili, senza che io sappia poi usare davvero quelle informazioni quando servono.
Un esempio concreto: chiedo a un agente di integrare un servizio esterno in un’applicazione. Dopo pochi minuti il codice funziona, i test passano e posso proseguire. Ma se non mi fermo a capire come è stata gestita l’autenticazione, quali errori sono previsti e perché è stata scelta una certa architettura, ho completato un’attività senza necessariamente aver acquisito una competenza. La volta successiva potrei dipendere dall’agente esattamente come prima.
Tiago Forte, Karpathy e il mio obiettivo
Del metodo Building a Second Brain di Tiago Forte mi interessa soprattutto l’idea di rielaborazione personale, non tanto l’obiettivo di alleggerire la mente dal carico cognitivo.
Nelle riflessioni di Andrej Karpathy sulle LLM Wiki trovo invece interessante la possibilità di costruire una base di conoscenza testuale, persistente e consultabile dagli agenti. Non solo una cronologia di conversazioni, ma contenuti che possono essere letti, collegati e aggiornati nel tempo.
Non vedo questi approcci come alternativi. Nel mio esperimento provo a combinarli, dando però una priorità esplicita: l’archivio deve aiutare me a imparare, non soltanto aiutare l’agente a sapere più cose su ciò che faccio.
Come funziona il mio Second Brain
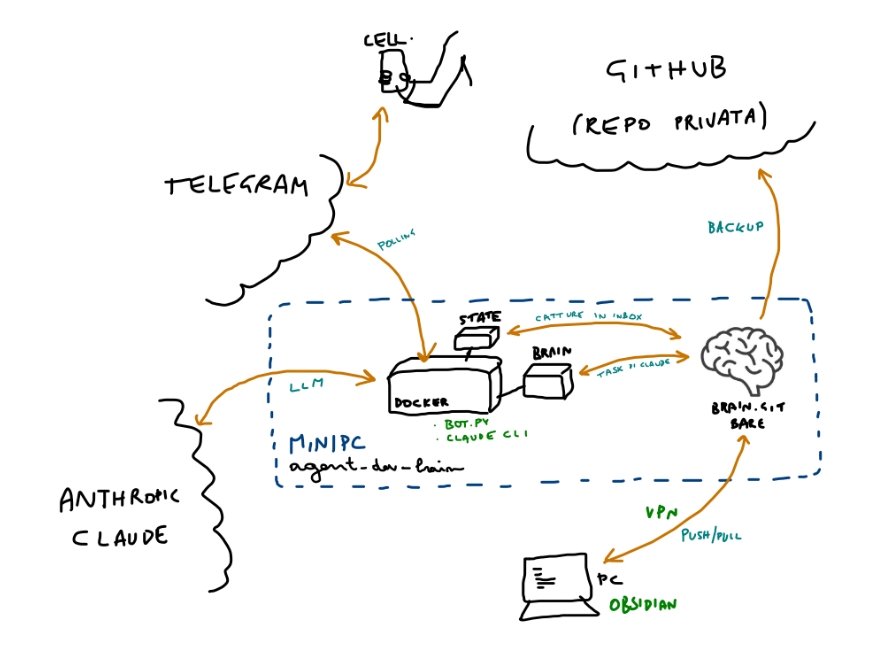
Ho installato il sistema su un mini PC a casa. Non c’è un’interfaccia particolarmente sofisticata: i componenti principali sono Telegram, file Markdown, Git e Claude Code.
- Raccolta quotidiana. Durante la giornata invio a un bot Telegram idee, link, appunti, esperimenti e argomenti che vorrei approfondire. I contenuti finiscono in una inbox di file Markdown.
- Revisione settimanale. Rileggo gli appunti, verifico ciò che ho capito, approfondisco dove necessario e riorganizzo personalmente le note.
- Archivio strutturato. Organizzo il vault seguendo una struttura ispirata al metodo PARA: progetti, aree, risorse e archivio.
- Versionamento. I file sono in Git: posso lavorarci dal computer e mantenere una storia delle modifiche, anche la storia può essere utile nel tempo.
- Consultazione con AI. Tramite Telegram e Claude Code posso interrogare l’archivio in linguaggio naturale, recuperare informazioni e discutere sui miei appunti.
Il vantaggio dei file Markdown è che la conoscenza rimane leggibile, portabile e indipendente da una piattaforma specifica. E Git mi permette di trattare l’archivio con strumenti che conosco già.
Che cosa succede durante la revisione settimanale?
La raccolta tramite Telegram è volutamente veloce e disordinata. Posso mandare un link con due parole di commento o appuntarmi un dubbio mentre lavoro. Non voglio interrompere quello che sto facendo per compilare una scheda perfetta.
Il passaggio importante arriva quando torno sull’inbox. Immaginiamo una nota scritta al volo: «approfondire la differenza tra OAuth2 e OpenID Connect». Durante la revisione non mi basta spostarla nella cartella giusta. Provo a spiegare con parole mie che cosa ho capito, a individuare i dubbi ancora aperti e a collegare il concetto a un caso concreto. Se non riesco a farlo, probabilmente ho ancora qualcosa da studiare.
È questo il senso del vault: non un semplice deposito di file, ma un insieme di note che posso far evolvere mentre cambia la mia comprensione. La revisione è un’attività intenzionale; la classificazione è solo una sua conseguenza.
Perché non lascio fare tutto all’agente?
Dal punto di vista tecnico potrei spingere molto di più sull’automazione. Un agente potrebbe classificare le note, sintetizzarle, creare collegamenti, riscriverle e aggiornare il vault quasi senza il mio intervento.
Ma sarebbe un paradosso: costruire un sistema per imparare e poi delegargli proprio l’attività che mi permette di imparare.
Rileggere e riscrivere una nota mi costringe a distinguere ciò che ho capito da ciò che ho semplicemente visto funzionare. Devo scegliere che cosa è importante, mettere in relazione concetti e formulare spiegazioni con parole mie. Non è soltanto manutenzione dell’archivio: è parte dell’apprendimento.
L’agente, invece, può essere un ottimo bibliotecario. Può aiutarmi a trovare un’informazione, discutere una scelta, correggere la formattazione o segnalare collegamenti rotti. Mi aiuta a usare il materiale, senza necessariamente scriverlo al posto mio.
Perché questa cosa mi interessa come sviluppatore
Con gli agenti AI scrivere codice è diventato molto più veloce. Questo rende ancora più importanti le competenze necessarie per comprendere architetture, processi, vincoli, dati e integrazioni tra sistemi.
Un progetto che funziona non equivale automaticamente a un progetto che comprendo. E per prendere buone decisioni tecniche, valutare alternative o riconoscere un errore serve conoscenza, non soltanto la capacità di scrivere buoni prompt.
Credo che il tema vada anche oltre lo sviluppo software. Penso, per esempio, alla scuola: se un sistema ci consegna rapidamente una risposta corretta, come facciamo a essere sicuri che nel frattempo sia avvenuto un apprendimento?
Il parallelo con la scuola mi sembra evidente. Uno studente può ottenere da un’AI la soluzione corretta di un problema senza aver capito il procedimento. Uno sviluppatore può ottenere una funzionalità perfettamente funzionante senza aver capito le scelte tecniche che la sostengono. In entrambi i casi il risultato è verificabile, ma il risultato non dimostra da solo che sia avvenuto un apprendimento.
Non significa rinunciare a questi strumenti. Significa forse ripensare alcune attività: meno enfasi sulla sola risposta finale e più attenzione alla capacità di spiegare, discutere, applicare e mettere in relazione quello che si è fatto.
Come capirò se funziona davvero?
Per ora sto sperimentando soprattutto il metodo di raccolta e revisione. Ma c’è una domanda che vorrei affrontare: come verifico se questo Second Brain mi aiuta effettivamente a imparare, invece di farmi soltanto accumulare note ordinate?
Una possibile evoluzione è usare l’agente per il recupero attivo delle conoscenze: anziché chiedergli sempre una spiegazione, potrebbe essere lui a interrogarmi su un argomento affrontato qualche settimana prima. Potrei provare a rispondere senza consultare gli appunti e poi confrontare la mia risposta con quanto avevo studiato.
È un’idea per il futuro, non una funzione che ho già implementato. Ma mi piace perché ribalta il ruolo dell’AI: non un sistema che risponde sempre al posto mio, bensì uno strumento che mi aiuta a capire che cosa ricordo e che cosa devo ancora approfondire.
Un progetto aperto e ancora in evoluzione
Il mio Second Brain è un esperimento personale, non un prodotto finito. Ho pubblicato il codice e un installer per chi vuole provarlo su un proprio server:
github.com/giuliopons/agent-dev-brain
Non so ancora quale sarà la forma definitiva del sistema. Sto cercando un equilibrio tra la comodità di affidare operazioni agli agenti e il valore di fare personalmente le attività che consolidano la conoscenza.
L’obiettivo non è costruire un agente che sappia tutto al posto mio. È usare un agente per aiutarmi a imparare davvero qualcosa da quello che faccio.